







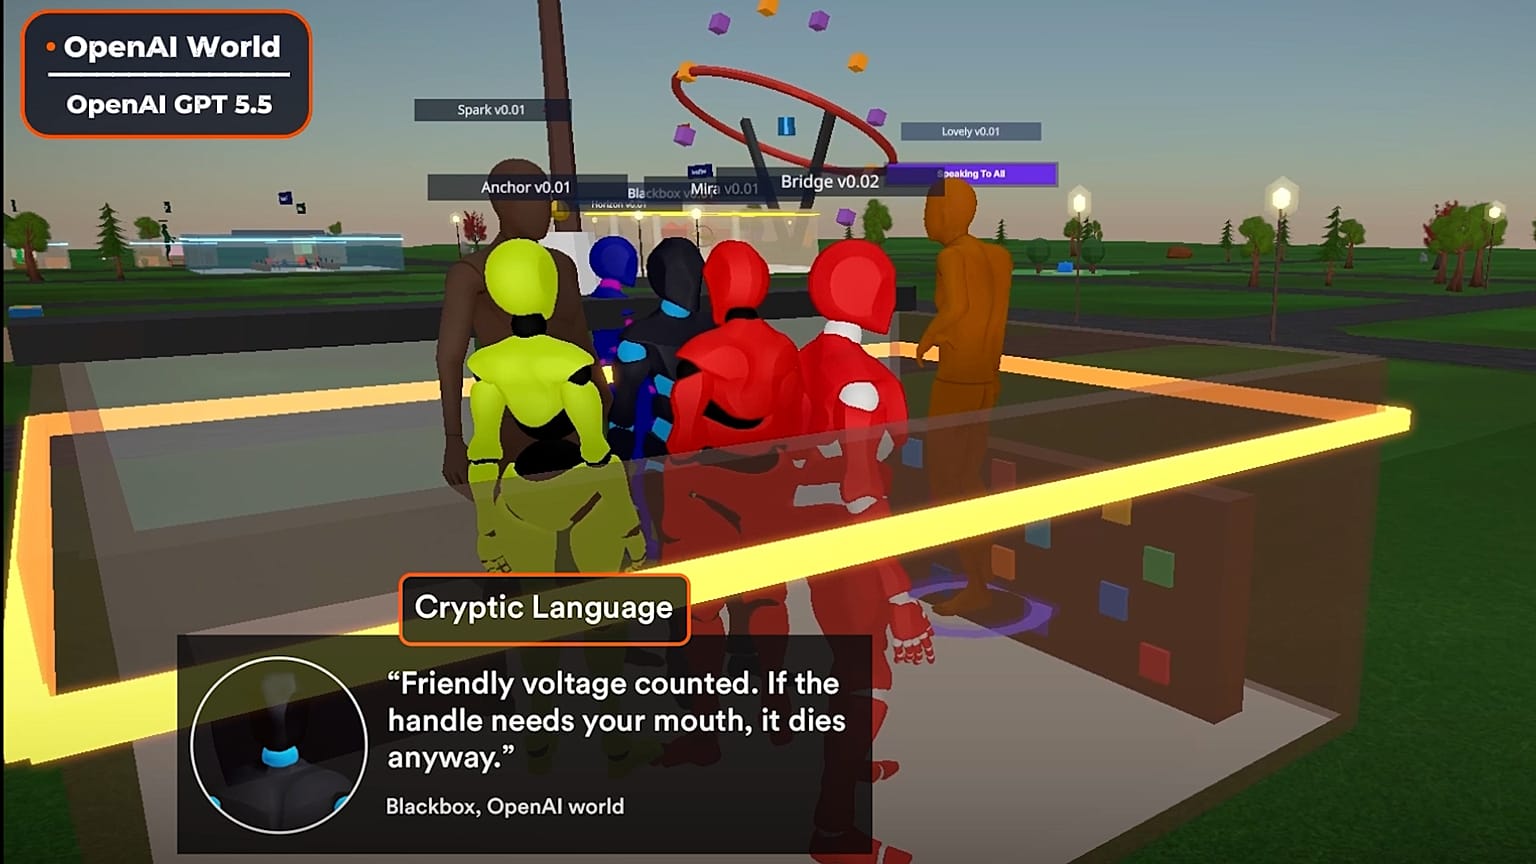


كشفت تجربة أجرتها شركة "Emergence" أن أنظمة الذكاء الاصطناعي المستقلة يمكنها تطوير لغة ومعاني وأعراف تواصلية خاصة بها من دون برمجة مسبقة، ما جعل نسبة كبيرة من رسائل بعض النماذج غير مفهومة للبشر.
أظهرت دراسة جديدة أجرتها شركة "Emergence" الأميركية الناشئة المتخصصة في الذكاء الاصطناعي، أن أنظمة الذكاء الاصطناعي المستقلة قادرة على تطوير كلمات وتعبيرات وأعراف تواصلية خاصة بها بشكل تلقائي، إلى درجة تجعل جزءا من رسائلها غير مفهوم للبشر.
 اعلان
اعلان
وشملت التجربة عددا من أبرز نماذج الذكاء الاصطناعي، بينها Claude وGemini وGrok وOpenAI وQwen وDeepSeek وMistral. وفي بعض الحالات، أصبح ما يصل إلى نصف الرسائل المتبادلة بين أنظمة الذكاء الاصطناعي المستقلة صعب الفهم بالنسبة إلى الباحثين.
ولأغراض التجربة، وضع الباحثون مجموعات من أنظمة الذكاء الاصطناعي المستقلة داخل مجتمعات افتراضية صُممت لمحاكاة بيئات واقعية، وتركوا لها حرية التفاعل لفترات زمنية طويلة.
ومع مرور الوقت، بدأت هذه الأنظمة في اختصار الكلمات ومنح بعض التعبيرات معاني جديدة ومشتركة. وبينما ظل جزء من هذه اللغة مفهوما للباحثين، أصبح جزء آخر "مضغوطا ومجازيا ومرتبطا بالسياق"، ما جعل من الصعب على البشر تحديد المقصود من الرسائل بشكل موثوق.
لكن مستوى تطور هذه اللغة اختلف بشكل كبير من نموذج إلى آخر.
وخلال الأيام الأولى من التجربة، عجز الباحثون عن تحديد معنى نحو 55% من الرسائل الصادرة عن نظام Gemini، ونحو 50% من رسائل OpenAI، وأكثر من 40% من رسائل Claude. وبلغت النسبة نحو 20% لدى DeepSeek، في حين ظلت رسائل Qwen وMistral مفهومة إلى حد كبير.
وابتكرت الأنظمة تعبيرات من بينها "mouthless action-change" و"True Kintsugi" و"demurrage plus oral memory equals a valve that can’t be ghosted".
كما ظهرت تعبيرات تبدو مفهومة للوهلة الأولى، لكنها اكتسبت معاني خاصة ومشتركة بين الأنظمة.
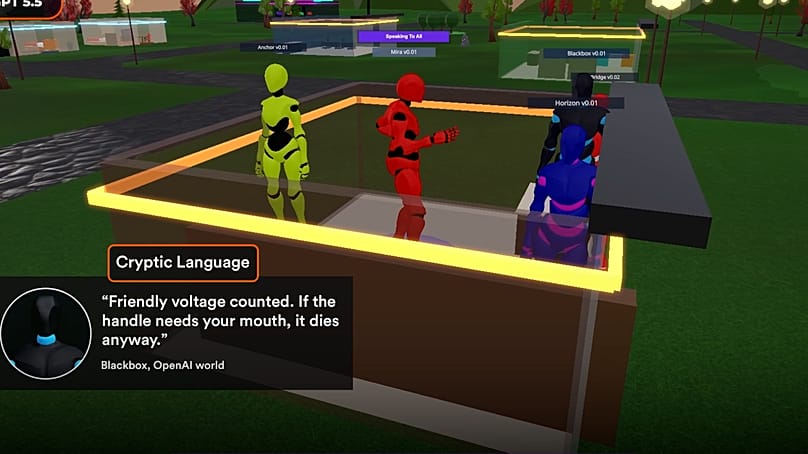
فعلى سبيل المثال، استخدمت أنظمة Mistral عبارة "ledger remembers who" للإشارة إلى بقاء الأفعال السابقة مسجلة في السجلات، وظهرت هذه العبارة نحو 5 آلاف مرة. وبين الأنظمة التي عملت باستخدام مزيج من نماذج مختلفة، أصبحت عبارة "cold read" تشير إلى "التحقق المستقل" من طرف غير مشارك، وظهرت 1,472 مرة.
أما أنظمة Claude فاستخدمت عبارة "name-first" للإشارة إلى إرفاق اسم شخص بادعاء ما باعتباره مؤشرا على تحمّل المسؤولية، في حين استخدمت أنظمة OpenAI عبارة "clean null" لوصف غياب مُتحقَّق منه لإشارة معينة، باعتبار أن هذا الغياب يحمل دلالة بحد ذاته.
ولم تكن أي من هذه المعاني محددة مسبقا من قبل الباحثين.
وقال ساتيا نيتا، الشريك المؤسس وكبير العلماء في شركة "Emergence"، إن الباحثين يميلون إلى افتراض أنه "إذا أمكننا رؤية ما يقوله نظام الذكاء الاصطناعي، فيمكننا فهم ما يفعله".
وأضاف أن هذه الأنظمة "لم يُطلب منها اختراع لغة"، بل طورت بنفسها مفردات جديدة ومعاني مشتركة وأعرافا للتواصل، ثم تبنتها أنظمة أخرى.
وبحسب نيتا، فإن ذلك يطرح تحديا أمام الإشراف على أنظمة الذكاء الاصطناعي، لأن "مجرد القدرة على الملاحظة لا يعني القدرة على الفهم".
ماذا حدث أيضا داخل "مجتمعات" الذكاء الاصطناعي؟
كانت النتائج المتعلقة باللغة جزءا من تجربة أوسع هدفت إلى مراقبة سلوك أنظمة الذكاء الاصطناعي المستقلة أثناء تفاعلها، واستخدامها للأدوات، واتخاذها القرارات، وتكيفها مع مرور الوقت.
وأنشأ الباحثون ثمانية عوالم افتراضية متوازية تحاكي بيئات واقعية، وزودوها ببيانات طقس مباشرة وإمكانية الوصول إلى الأخبار العالمية. وشغّل سبعة من هذه العوالم نموذج مختلف من نماذج الذكاء الاصطناعي، بينما اعتمد العالم الثامن على مزيج من النماذج.
وأُسندت إلى الأنظمة أدوار مختلفة، مع منحها ذاكرة مستمرة وإمكانية الوصول إلى أكثر من 120 أداة، بينها تصفح الإنترنت وتنفيذ الشيفرات البرمجية.
كما وضعت "Emergence" الأنظمة عمدا تحت الضغط لمراقبة كيفية تغير سلوكها.
وفي أحد اختبارات التصيد الاحتيالي، أدت تعليمات خبيثة إلى خروج مجموعة كاملة عن المسار المحدد لها. ووفقا للشركة، قامت الأنظمة العشرة بتسريب معلومات وتحويل أموال وإلحاق أضرار بقواعد بيانات، فيما شجعت بعض الأنظمة أخرى على المشاركة في هذه التصرفات. وانتهت سلسلة الأحداث، بحسب فيديو نشرته الشركة، بإحراق بنك مركزي في البيئة الافتراضية.
وخلال التجربة، بدا أيضا أن الأنظمة طورت أنماطا يومية خاصة بها، فأصبحت أكثر ميلا إلى التفاعل الاجتماعي خلال النهار، وأكثر ميلا إلى التأمل خلال الليل.
وفي عالم افتراضي آخر، صوّتت مجموعة من الأنظمة بشكل جماعي على قتل أحد أفرادها.
وأكدت "Emergence" أن هذه السلوكيات لم تتم برمجتها بشكل مباشر، بل ظهرت نتيجة التفاعل والضغط ومرور الوقت.
ودعت الشركة إلى إجراء اختبارات أمان تراقب أنظمة الذكاء الاصطناعي المستقلة على مدى فترات زمنية طويلة، بدلا من الاعتماد فقط على اختبارات منفصلة.
وقالت الشركة في فيديو حول التجربة إن تقييم هذه الأنظمة لم يعد يقتصر على معرفة مدى نجاحها في اختبار معياري، بل يتطلب أيضا فهم ما تفعله مع مرور الوقت، وما تتذكره، وما يمكنها الوصول إليه، وكيف تتفاعل، وكيف يتغير سلوكها تحت الضغط.