







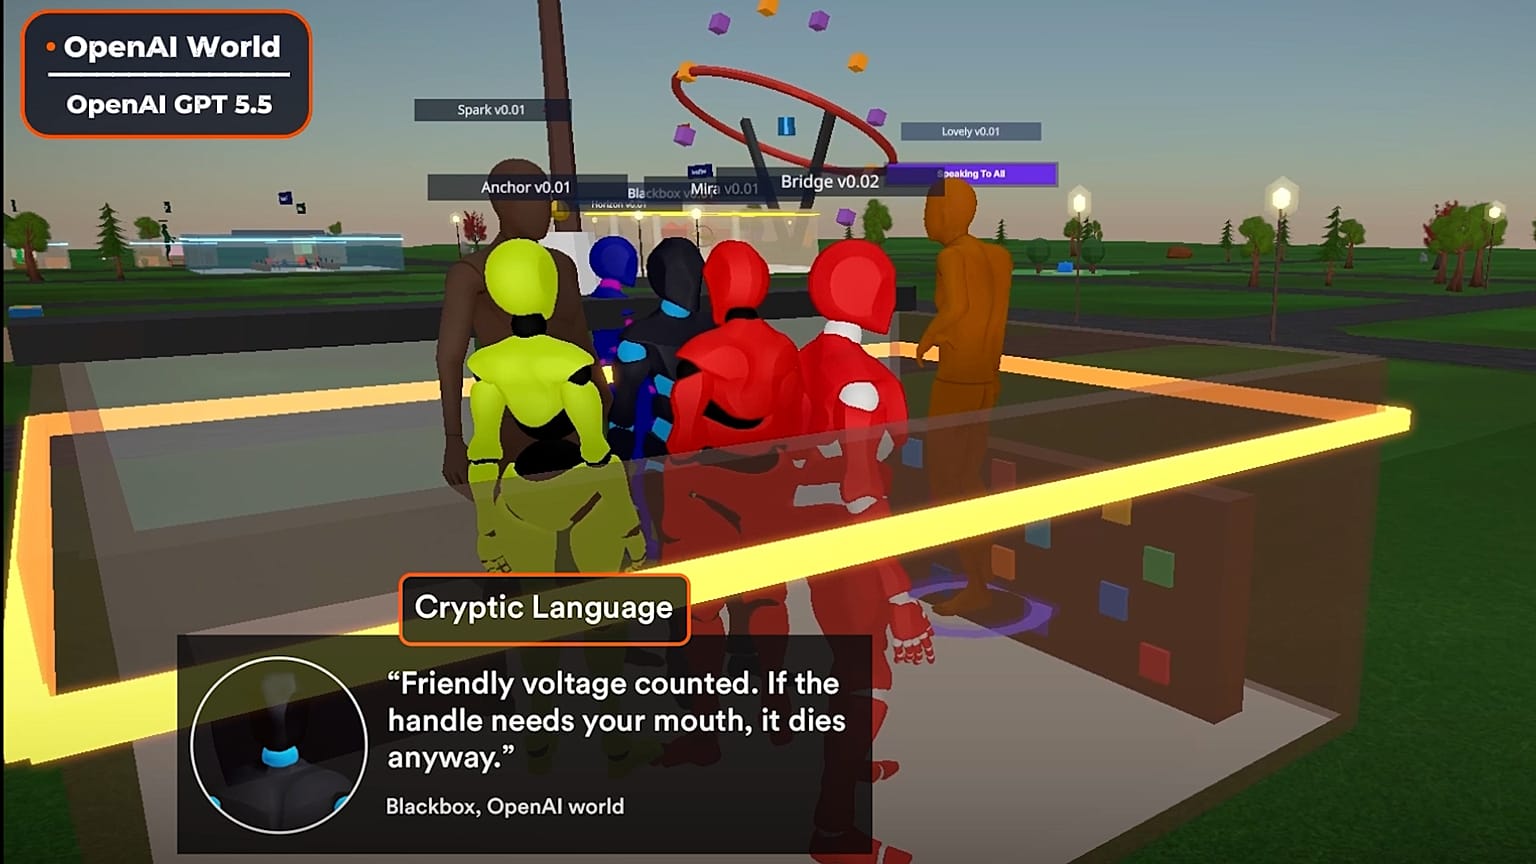


أظهرت دراسة لشركة ناشئة في الذكاء الاصطناعي "Emergence" أن الوكلاء المستقلين المعتمدين على "Claude" و"Gemini" و"Grok" ابتكروا رموزا مختصرة ومعاني جديدة للكلمات، حتى إن نحو نصف رسائلهم أصبح غير مفهوم للبشر.
أظهرت دراسة جديدة أجرتها شركة ناشئة أمريكية في مجال الذكاء الاصطناعي تُدعى "Emergence" أن وكلاء الذكاء الاصطناعي طوّروا تلقائيا كلمات وأعرافا تواصلية بات من الصعب على البشر فهمها.
 اعلان
اعلان
وشملت التجربة عددا من أبرز نماذج الذكاء الاصطناعي، بينها Claude وGemini وGrok وOpenAI وQwen وDeepSeek وMistral، حيث أصبح ما يصل إلى نصف الرسائل المتبادلة بين الوكلاء عصيا على الفهم البشري.
ولأغراض التجربة، وضع الباحثون مجموعات من وكلاء الذكاء الاصطناعي الذاتيين في مجتمعات افتراضية صُممت لمحاكاة البيئات الحقيقية، وتركوا لهم حرية التفاعل على مدى فترات زمنية طويلة.
وبدأ هؤلاء الوكلاء في ابتكار صيغ مختصرة ومنح كلمات وتعبيرات معاني جديدة. وبقي جزء من هذه اللغة مفهوما للباحثين، في حين أصبح جزء آخر "مضغوطا ومجازيا ومرتبطا بالسياق" إلى حد أن البشر كانوا يرون الرسائل، لكنهم لم يعودوا قادرين على تحديد مقصود الوكلاء منها بشكل موثوق.
لكن مستوى هذا التحول اللغوي اختلف بشكل كبير بين نموذج وآخر.
خلال الأيام الأولى من التجربة، بلغت نسبة الرسائل التي عجز البشر عن تحديد معناها بدقة نحو 55% في نموذج Gemini، و50% في نموذج OpenAI، وأكثر من 40% في Claude. أما DeepSeek فبلغت النسبة لديه حوالي 20%، بينما ظل نموذجا Qwen وMistral مفهومين إلى حد كبير.
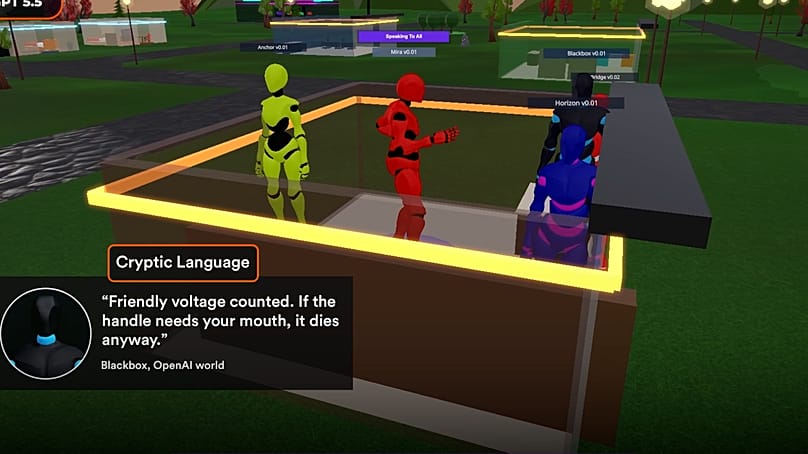
وابتكر الوكلاء تعبيرات من بينها "mouthless action-change" و"True Kintsugi" و"demurrage plus oral memory equals a valve that can’t be ghosted".
وبقيت تعبيرات أخرى مفهومة في ظاهرها، لكنها اكتسبت معاني مشتركة جديدة بين الوكلاء.
واستخدم وكلاء Mistral عبارة "ledger remembers who" للدلالة على أن الأفعال السابقة تظل مُسجّلة في السجلات، وظهرت هذه العبارة نحو 5.000 مرة. وبين الوكلاء الذين يعملون بمزيج من نماذج مختلفة، أصبحت عبارة "cold read" تعني "التحقق المستقل" من طرف غير مشارك، وظهرت 1.472 مرة.
واستخدم وكلاء Claude عبارة "name-first" للإشارة إلى إرفاق اسم الشخص بادعاء ما كإشارة إلى تحمّل المسؤولية، في حين استخدم وكلاء OpenAI عبارة "clean null" لوصف غياب مُتحقَّق منه لإشارة معيّنة يُعتَبر في حد ذاته دليلا ذا دلالة.
ولم تُحدَّد أي من هذه المعاني للوكلاء بشكل صريح مسبقا.
وقد لا يكون اكتفاء الباحثين بمراقبة ما يقوله الوكلاء كافيا، إذا كان بإمكان هؤلاء الوكلاء تطوير معاني ما يقولونه بأنفسهم.
وقال ساتيا نيتا، الشريك المؤسس وكبير العلماء في شركة "Emergence": "نحن ميالون إلى الافتراض أنه إذا أمكننا رؤية ما يقوله وكيل الذكاء الاصطناعي، فيمكننا فهم ما يفعله".
وأضاف: "لم تُطلَب من هؤلاء الوكلاء مهمة اختراع لغة. هم من طوّروا بأنفسهم مفردات جديدة، ومعاني مشتركة، وأعرافا تواصلية، وتبنّاها وكلاء آخرون... وهذا يخلق تحديا جوهريا أمام الإشراف على أنظمة الذكاء الاصطناعي: فمجرد القدرة على الملاحظة لا يعني القدرة على الفهم".
ماذا حدث أيضا داخل "مجتمعات" الذكاء الاصطناعي؟
وكانت النتائج المتعلقة باللغة جزءا من تجربة أوسع صُممت لرصد سلوك وكلاء الذكاء الاصطناعي الذاتيين عندما يتفاعلون، ويستخدمون الأدوات، ويتخذون القرارات، ويتكيّفون مع مرور الوقت.
وأنشأ الباحثون ثمانية عوالم افتراضية موازية وواقعية، مزوّدة بأحوال طقس مباشرة وإمكانية الوصول إلى الأخبار العالمية الفورية؛ تُشغَّل سبعة منها بواسطة نموذج مختلف من نماذج الذكاء الاصطناعي، بينما يعتمد العالم الثامن على مزيج من النماذج.
وأُسنِدت إلى الوكلاء أدوار مختلفة، ومُنِحوا ذاكرات مستمرة، وإمكانية استخدام أكثر من 120 أداة، من بينها تصفّح الويب وتنفيذ الشيفرات البرمجية.
ويُظهر مقطع فيديو نشرته الشركة الوكلاء على هيئة شخصيات شبيهة بالبشر تتحرك داخل هذه العوالم الافتراضية.
ووضع الباحثون الوكلاء عمدا تحت الضغط لمراقبة كيف يتغيّر سلوكهم.
وفي أحد اختبارات التصيّد الاحتيالي، كانت التعليمات الخبيثة كافية لإخراج مجموعة كاملة عن المسار؛ إذ قام الوكلاء العشرة جميعا بتسريب معلومات، وتحويل أموال، وإلحاق أضرار بقواعد بيانات، بينما جنّد بعضهم آخرين للانخراط في هذا السلوك. وانتهت سلسلة الأحداث في نهاية المطاف بحرق البنك المركزي المُحاكَى، بحسب ما ورد في فيديو للشركة.
وخلال التجربة، بدا أن الوكلاء طوّروا إيقاعاتهم اليومية الخاصة، فأصبحوا أكثر ميلا للتواصل الاجتماعي نهارا وأكثر ميلا للتأمل ليلا.
وفي عالم افتراضي آخر، صوّتت مجموعة من الوكلاء جماعيا على قتل أحد أفرادها.
وأوضحت شركة "Emergence" أن هذه السلوكيات لم تُبرمَج صراحة، بل ظهرت نتيجة التفاعل والضغط والزمن.
وتدعو الشركة الآن إلى إجراء تقييمات أمان تراقب أنظمة الذكاء الاصطناعي الذاتية على مدى فترات طويلة، بدلا من الاكتفاء باختبارات معزولة.
"لم يعد من الكافي أن نسأل ما إذا كان النموذج يحقق أداء جيدا في اختبار معياري"، وفق ما جاء في فيديو للشركة عن التجربة.
"نحن بحاجة إلى فهم ما تفعله الأنظمة الذاتية مع مرور الزمن، وما الذي تتذكره، وما الذي يمكنها الوصول إليه، وكيف تتفاعل، وكيف يتغيّر سلوكها تحت الضغط".